Ses AI'nin gizli sorunu: doğal konuşma değil, kelime kaçırma
PolyAI'nin CTO'su Shawn Wen, tam çift yönlü (full-duplex) ses modellerinin artık mevcut olduğunu söylerken aynı zamanda şunu ekliyor: ses AI'si hâlâ kendi 'ChatGPT anı'nı yaşamadı. Bunun nedeni reasoning hızının yavaş kalması. Haftada birkaç yeni model yayınlanan, milyarlarca dolarlık risk sermayesi alan ve neredeyse insanımsı konuşma vaadi yapan bir alanda, sektörün lider isimleri beklenen dönüşümün henüz gerçekleşmediğini kabul ediyor.
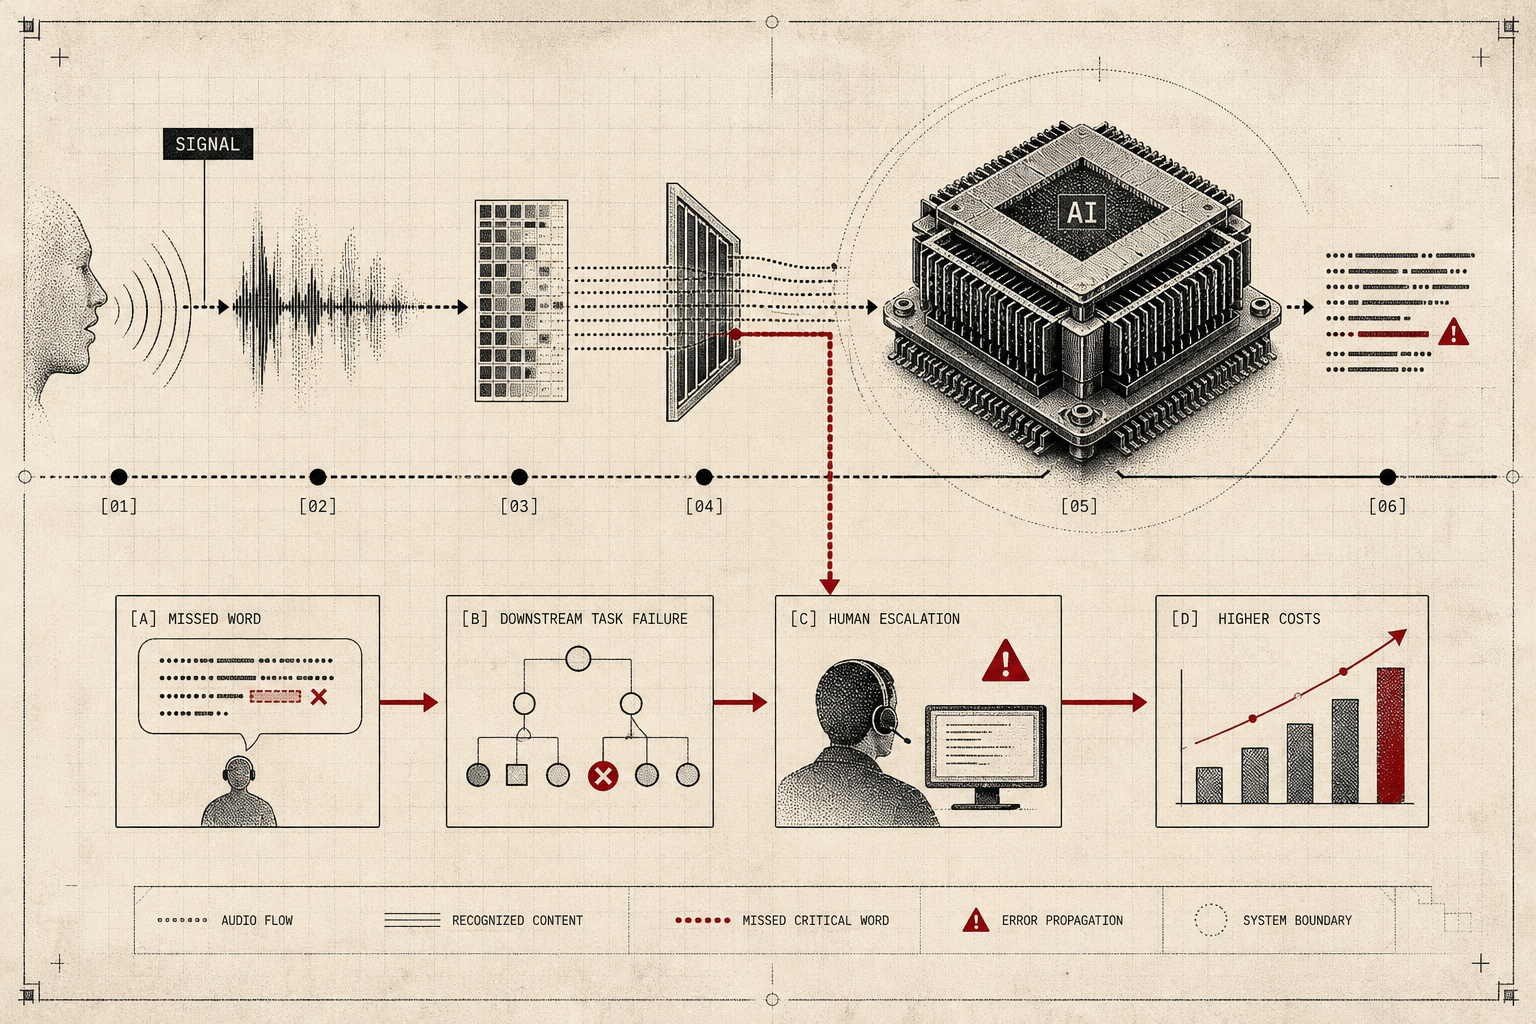
Sorun, teknolojinin sesinin yeterince yumuşak veya doğal olmaması değil. Sorun, konuşmadan görevi tamamlamaya uzanan zincirde yaşanan sessiz arızalar. Otomatik konuşma tanıma (ASR) modelleri, özellikle isimler, sayılar ve teknik terimlerde kritik anahtar kelimeleri kaçırıyor. Bu hatalar bağlam yakalama başarısızlığı yaratıyor ve tüm aşağı akış otomasyonunu bozuyor. Otter'ın müşteri başarısından sorumlu başkan yardımcısı Alex Gay'in vurguladığı gibi, transkripsiyon doğruluğu doğrudan aşağı akış otomasyon güvenini ve verimlilik kazançlarını etkiliyor.
Doğal ses yanılgısı: akıcılık doğruluğun yerini tutmuyor
Pazarlama materyalleri ve ürün demoları, ses AI'nin insandan ayırt edilemez tonda konuşabildiğini gösteriyor. Ancak kontrollü demo koşulları üretim ortamındaki gerçek performansı öngörmüyor. Müşteri hizmetleri, toplantı kayıt asistanları ve sesli iş akışlarında kritik olan şey sesin insanımsılığı değil, sistemin elde ettiği bilgiyi doğru şekilde anlaması ve sonraki adımlara güvenilir bir şekilde iletmesi.
Ses AI ajanları müşteri hizmetlerinde kullanıldığında, doğal ses kalitesi hâlâ önemli. 2-3 sohbet turu boyunca müşteri güvenini oluşturmak için bir seviyede insanımsılık gerekiyor. Ama güven oluştuktan sonra zincirde yaşanan başarısızlık, yumuşak bir sesin sağladığı ilk izlenim avantajını hızla siliyor. Müşteri, kendisine nazik bir tonla yanlış sipariş numarası, yanlış adres veya yanlış ödeme tutarı tekrarlayan bir sistemle ikinci kez konuşmak istemiyor.
Konuşma tanıma hataları ve aşağı akış zararı
ASR modellerinin en büyük açığı bağlamın yetersiz kalmasında. Bir toplantıda geçen teknik terim, bir müşteri hizmetleri çağrısında söylenen sipariş kodu ya da kişi ismi yanlış tanındığında, o bilgi doğru bir transkripsiyon satırı olarak sistemde saklanıyor ama aslında yanlış. Bu hata zincirin geri kalanına kusursuz bir girdi gibi görünüyor.
Konuşma tanıma modellerinin özellikle isimler, sayılar ve teknik terimlerde önemli anahtar kelimeleri kaçırdığı biliniyor. Bu tür hatalar otomasyon sistemlerinde katlanarak büyüyor. Bir müşteri "Model numarası XB-1745" dediğinde sistem "XD-1745" olarak kaydederse, envanter sorgusu başarısız olur ve çağrı bir insana aktarılır. Ses AI'nin bu durumda sağladığı tek şey, bir insan temsilcinin baştan dinlemesi gereken yanlış kayıt olur.
Transkripsiyon doğruluğu tek başına hedef olarak görülse de, aslında temelden bir katman. Transkripsiyon hatası tüm aşağı akış otomasyonunu bozar ve kullanıcı güvenini aşındırır. Bir toplantı not asistanının adları karıştırması, aksiyon maddelerini yanlış kişilere ataması veya önemli bir karar noktasını atlayarak kaydetmemesi, üretkenlik vaadini geriye döndürür. Kullanıcıların notları düzeltmek için harcadığı süre, aracın kazandırdığı zamandan fazla olursa araç kullanım dışı kalır.
Reasoning hızı ve görev tamamlama arasındaki ayrım
Full-duplex ses modelleri daha doğal diyalog olanağı sunuyor; kullanıcı konuşurken sistem dinliyor ve anında yanıt hazırlayabiliyor. Ancak full-duplex yetenekleri temel tanıma, reasoning ve yürütme sorunlarını çözmüyor.
Reasoning hızı yavaş kaldığı sürece tam doğal konuşma hissi yaratılamıyor. Gizli bir kavram ayrımı burada var: hızlı yanıt verme ile görev tamamlama birbirinden farklı yetenek. Bir sistem anında "Anlıyorum, kontrol ediyorum" diyebilir ama ardından bilgiyi doğru çekemez, yanlış veriyi işler veya talebi yanlış yere yönlendirir.
Müşteri bir bilgi istediğinde AI'nin hemen yanıt vermesi değil, doğru bilgiyi güvenilir şekilde getirmesi önemli. Burada yaşanan gecikme 2-3 saniye olsa bile, elde edilen verinin doğru olması akıcı ama yanlış bir cevaptan çok daha değerli.
Kurumsal ses AI'de ölçülmesi gereken metrikler
Kurumsal alıcılar ve karar vericiler için ses AI'nin performansını değerlendirirken transkripsiyon doğruluğu tek başına yanıltıcı bir metrik. Kurumsal ses sistemleri görev tamamlama oranları ve doğrulanmış çözüm ile daha doğru şekilde değerlendiriliyor.
Görev tamamlama oranı, bir çağrının veya toplantının sonunda kullanıcının ihtiyacının tam olarak karşılanıp karşılanmadığını ölçüyor. Transkripsiyon %95 doğru olsa bile görev tamamlama %70 kalabilir. Çünkü eksik bağlam, yanlış yönlendirme veya reasoning hatası sistemin doğru transkripti yanlış iş akışına bağlamasına neden olabilir.
İkinci önemli metrik doğrulanmış çözümdür. Müşteri hizmetlerinde bir çağrı "çözüldü" olarak işaretlense bile, müşterinin aynı konu hakkında bir hafta içinde tekrar arama yapması o çözümün gerçek olmadığını gösterir. Benzer şekilde toplantı not asistanının ürettiği özetler, katılımcıların manuel kontrolünden geçmeden doğrudan kullanılabilir değilse, araç verimlilik değil ek iş yükü yaratıyor demektir.
Ses AI'nin iş durumu hata düzeltme, eskalasyon ve yeniden çalışma maliyetlerini içeren toplam ekonomi ile belirleniyor. Bir sistem günde 1000 çağrı işleyip 200'ünü insana aktarıyorsa ve aktarılan çağrılar ilk turda yanlış yönlendirildiği için daha uzun sürüyorsa, o sistemin ROI negatif olabilir.
Şeffaflık ve güven: AI olduğunu söylemek neden kritik
Ses AI'nin kurumsal güvenilirlikte karşılaştığı bir başka sorun, kullanıcıların ne zaman bir AI ile konuştuklarını bilip bilmedikleri. Ses araçlarının kullanıcıya kaydedildiklerini veya AI ile konuştuklarını açıkça ifade etmesi gereken şeffaflık gerekliliği var.
Bu yasal ve etik bir gereklilik olmanın ötesinde, güven ekonomisi meselesidir. Bir kullanıcı AI olduğunu bilmediği bir sistemle konuşup bilgi aldığında ve sonra o bilginin yanlış olduğunu fark ettiğinde, hem kuruluşa hem AI teknolojisine olan güveni sarsılır. Oysa başta "Bu bir AI asistanıdır" denildiğinde, kullanıcı beklentisini ayarlayarak daha dikkatli dinliyor, çıktıları teyit ediyor ve sistemin sınırlarını kabul ediyor.
Müşteri hizmetlerinde AI ajanlarının kendilerini tanıtması, başlangıçta ufak bir güven kaybı yaratsa bile uzun vadede daha az şikayete ve daha az eskalasyona yol açıyor. Toplantı kayıt asistanlarında ise katılımcıların kaydedildiğini bilmesi, konuşma tarzını biraz değiştirse bile şirketin yasal riskini düşürüyor ve sonradan "bu kayıt nereden geldi?" sorusunu önlüyor.
Dijital ikiz seslendirme ve duygu ifadesi açığı
Ses AI'nin bir başka kullanım alanı dijital ikiz (digital twin) avatarlar: bir kişinin sesinin kopyalanarak toplantılarda kendisi yerine konuşması veya içerik üretmesi. Dijital ikiz ses teknolojisi duygusal ifadeleri aktarabilmeli, aksi takdirde insan toplantı dinamiklerini taklit edemez ve basit bir Q&A chatbot'u gibi görünür.
Bu alan henüz çok erken aşamada ve teknik sınırlamalar belirgin. Bir kişinin ses tonunu kopyalamak, bunu etkileşimli ve bağlama duyarlı şekilde kullanmaktan farklıdır. Şu anki dijital ikiz uygulamaları genellikle önceden hazırlanmış yanıtlar veya basit sorguları sesli yanıtlarla karşılayabiliyor. Gerçek zamanlı reasoning, tartışma takibi ve duygusal modülasyon henüz güvenilir seviyede değil.
Bu yüzden dijital ikiz ses teknolojisi şimdilik üretim ortamında sınırlı kalıyor. Müşteri başarı toplantılarında veya satış görüşmelerinde bir AI'nin gerçek kişinin yerini alması, güven kaybından çok risk taşıyor.
Türkiye'de aksan ve teknik terminoloji riski
Türkiye bağlamında ses AI'nin karşılaştığı ek bir engel yerel aksan çeşitliliği ve teknik terminolojinin İngilizce-Türkçe karışık kullanımıdır. ASR modelleri genellikle standart aksanlara göre eğitildiği için, Anadolu'nun farklı bölgelerinden gelen aksan varyasyonlarında hata oranı yükseliyor.
Teknik destek çağrılarında veya iş toplantılarında "deployment", "pipeline", "cluster" gibi İngilizce terimlerin Türkçe cümleler arasında kullanılması, ses tanıma için ek bir karmaşıklık katmanı oluşturuyor. Model bu terimleri Türkçe sesbirim dizisi olarak anlamaya çalıştığında genellikle yanlış transkript üretiyor. Örneğin "cluster kurulumu" ifadesi "klasör kurulumu" olarak kaydedilebiliyor.
Bu risk özellikle müşteri hizmetlerinde ve toplantı not asistanlarında belirgindir. Yazılım şirketlerinde Türkçe yürütülen sprint toplantılarında İngilizce terim yoğunluğu kayda değer olabilir. Ses AI'nin bu içeriği doğru yakalaması ve anlamlandırması için çok dilli ve aksan duyarlı modellere ihtiyaç vardır.
Ses AI ne zaman gerçekten iş için hazır olacak?
Ses AI'nin kendi 'ChatGPT anı'nı yaşaması için gereken şey, doğal konuşma sesinden çok reasoning hızının artması ve konuşma tanıma doğruluğunun özellikle kritik veri noktalarında sıfıra yakın hata oranına düşmesidir. Full-duplex modeller daha akıcı konuşma deneyimi sunuyor ama bunlar temel tanıma, reasoning ve yürütme sorunlarını çözmüyor.
Kurumsal alıcılar için karar anı, ses AI'nin iş akışına entegre edildiğinde net pozitif ROI yaratıp yaratmadığıdır. Bu ROI hesabında hata düzeltme maliyeti, insan müdahalesi oranı, yeniden çalışma yükü ve müşteri memnuniyeti kaybı yer alır. Şu an için çoğu ses AI uygulaması pilot projelerde kalıyor çünkü üretim ölçeğinde güvenilirlik henüz yeterli değildir.
Bir ses AI aracı değerlendirirken üç soruya yanıt bulmalısın: Transkripsiyon doğruluğu isimler, sayılar ve model kodları gibi kritik veri noktalarında ne kadar? Görev tamamlama oranı nedir, yani sistem kaç çağrı veya toplantıda kullanıcının ihtiyacını ilk seferde tam olarak karşılıyor? İnsan eskalasyon oranı nedir ve bu eskalasyonlar ne tür hatalarda gerçekleşiyor? Kullanıcılar çıktıları ne sıklıkla manuel olarak düzeltmek zorunda kalıyor? Kullanıcıya AI olduğu açıkça bildiriliyor mu? Yanıtlar doğal ses kalitesine değil, bu metrikler üzerinde yoğunlaşmalıdır. En iyi değerlendirme, üretim ortamında aksan, gürültü ve eksik bilgi içeren gerçek koşullarda kontrollü bir pilot projesi yürütmek ve yukarıdaki metrikleri dokümante etmektir.